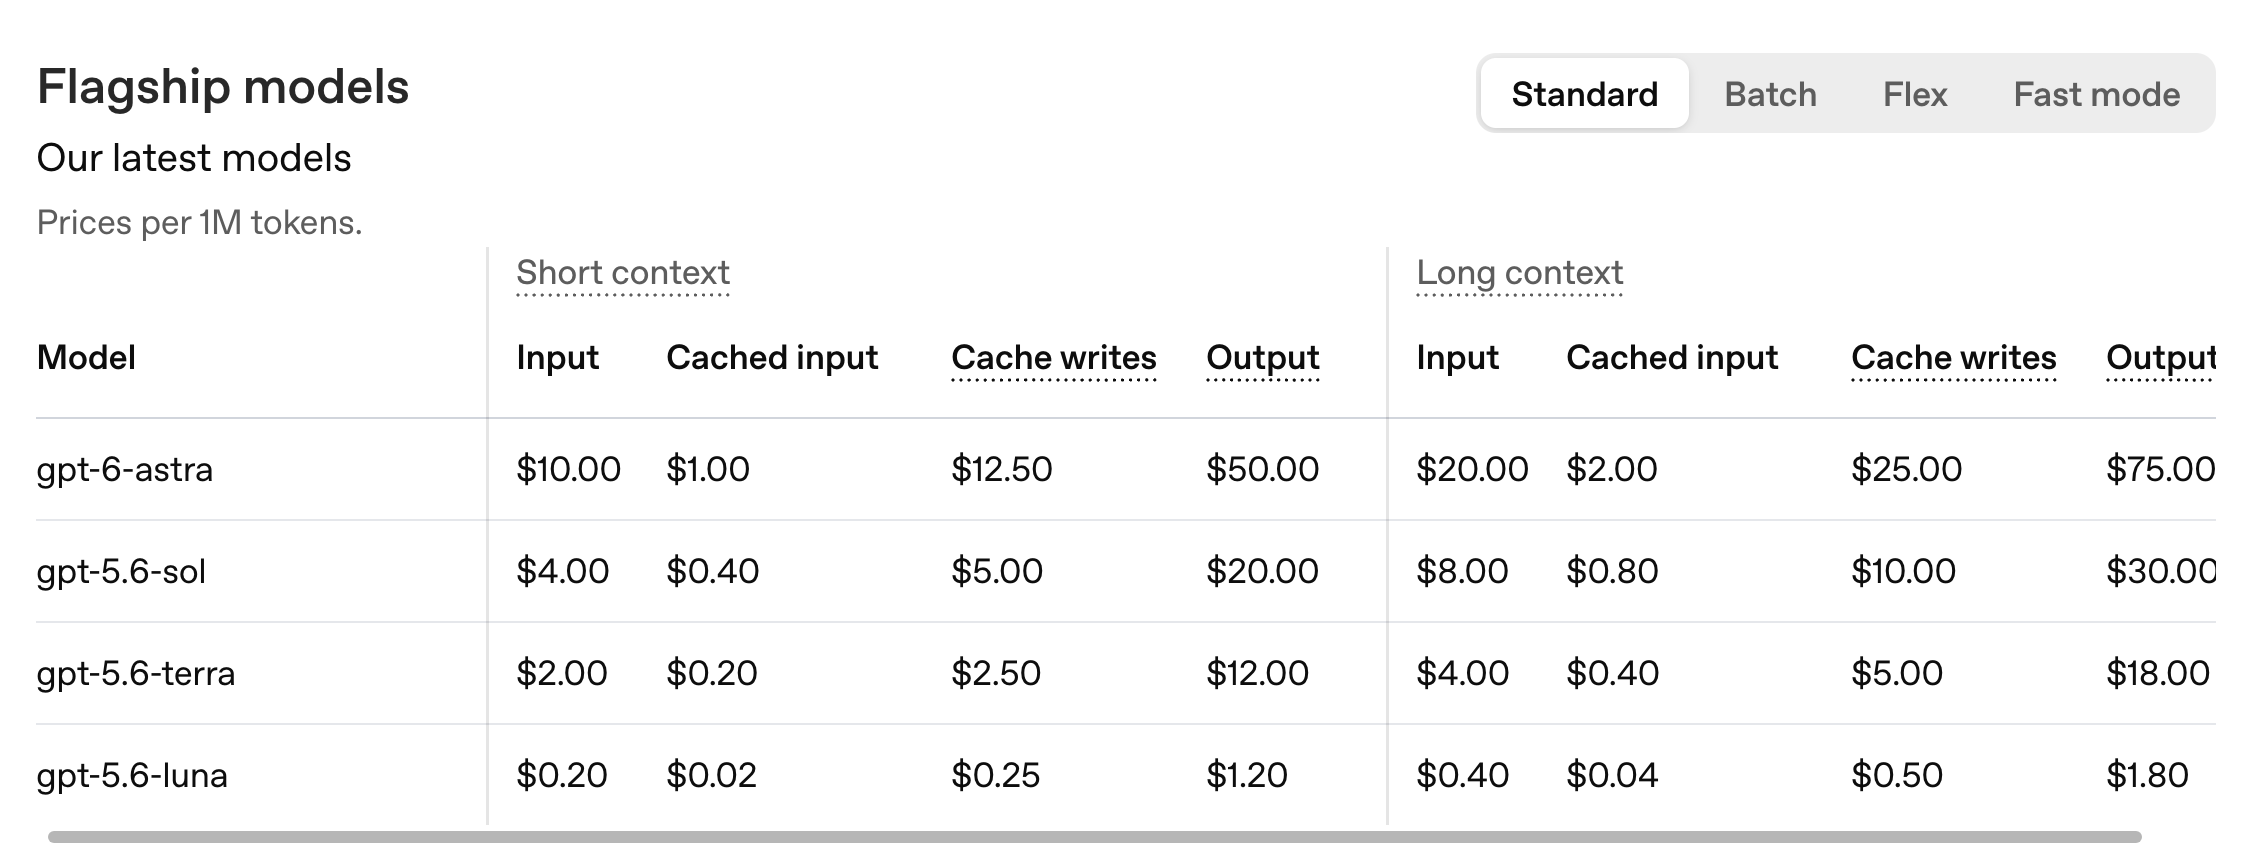
GPT 6 实在是太贵了,整理几个省 token 的 tips 。大家可以看下下面的价格表:
1. 清理一下不必要的 skill
每个 skill 都可能带来额外的系统提示、工具说明和行为约束。skill 越多,模型每一轮需要处理的固定上下文越大,也越容易出现指令冲突。
OpenAI Codex 团队 Eric 针对 GPT-6 Astra 写的《Rethinking skills and prompts》,里面有提到如果过去一年积累了大量 AGENTS.md 和 Skill 那么可以针对GPT-6 Astra 做一次整理。
直接把这段提示词发给 Codex:
请扫描当前可访问的全局配置、AGENTS.md 和已加载的 Skill 规则,针对 GPT-6 Astra 做一次整理:
1、找出那些为了防范老模型而写的陈旧规则,特别是容易导致 Astra 频繁停下来发问、或者连改个小地方也要遍历全仓的过度限制,引用原句说明。
2、重新理清执行边界,只读检索、本地草稿和常规测试允许自主推断并继续推进,只在涉及不可逆修改时才停下来等待确认。
3、检查每个 Skill 的描述,收拢大段流程细节,只保留明确的触发场景,避免平时无关任务过早把 Skill 全量塞进上下文。
4、确立规则优先级,当产生冲突时,以当前具体任务为最高优先级,其次是项目本身的 AGENTS.md,最后才是外部引入的通用 Skill。
5、列出修改说明,输出一份可直接覆盖的纯净版 AGENTS.md,并附上各个 Skill 的瘦身建议
2. 同一个窗口处理任务不要跨天
如果任务已经完成,第二天不要为了“接着聊”而继续复用一个很长的窗口。旧窗口通常已经积累了大量历史消息、工具输出和失败尝试。即使当前问题很简单,模型仍然要携带这些内容参与推理。然后 Codex prompt 里面会携带 current_date 信息,跨天之后 cache miss 的 prefix 比较长的话,就比较贵了:
<environment_context>
  <cwd>/xxx/project</cwd>
  <shell>zsh</shell>
  <current_date>2026-09-18</current_date>
  <timezone>Asia/Singapore</timezone>
</environment_context>
所以假设请求大致是:
[system instructions]
[developer instructions]
[tools]
[environment_context]
  current_date = 2026-09-18
[/environment_context]

[user message 1]
[assistant message 1]
[user message 2]
...
第二天从变化 token 开始,后面的 prefix 就不能继续和昨天的请求完全匹配:
AAAAAAAAAAAAAAAAAAAAAAAAAAAA
                            ↑
                    current_date changed
                            ↓
BBBBBBBBBBBBBBBBBBBBBBBBBBBB
更好的方式是:在当天结束时,把任务状态、已经确认的事实、剩余问题和关键文件写入一个短的 handoff 文件。第二天新开窗口,只读取这份摘要和当前需要的文件。
例如:
目标:为支付模块增加重试机制
已完成:确认入口在 src/payment/retry.go
已确认:超时错误可以重试,参数错误不能重试
待完成:补充单元测试,运行 go test ./payment/...
注意:不要修改公共 API
新窗口只需要几百个 token,就可以恢复工作,不需要重新携带一整天的历史。
3. 同一个窗口不要更换模型
有时候同一个窗口本来以为自己切换一下模型,本来窗口内用 GPT 6,偶尔简单的任务切换成 GPT 5.6 可能会更加省钱,但实际上不是这样。
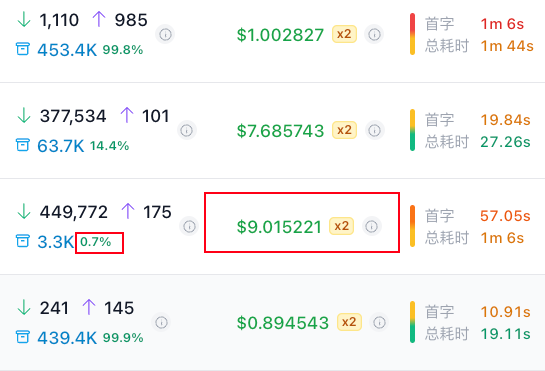
在同一个任务窗口中更换模型,可能导致旧模型留下的缓存无法在新模型的命名空间里复用,后续请求需要重新计算上下文。这样看起来只是换了一个模型,实际可能把之前积累的缓存优势全部丢掉。
因此最好在任务开始前先决定模型:
- 复杂规划、跨文件重构、难定位的问题,使用能力更强的模型;
- 简单改名、格式化、查找、补充注释,使用便宜模型;
- 一个窗口内尽量保持模型稳定;
- 如果确实要换模型,先把当前状态压缩成摘要,再开一个新窗口。
4. 控制上下文大小,不要超过 272K
上下文窗口越大,不代表模型就能同样高质量地处理所有信息。上下文变长后,模型需要检索的内容更多,旧信息之间也更容易互相干扰。对 coding agent 来说,真正有价值的通常是当前任务、相关文件、错误日志和最近几轮决策。我们可以看到如果是 Long context 的话每百万 output 的token 费用是 75 刀。要知道 deepseek 4.1 flash 即使是高峰时期才 8 RMB/1M token
所以,我们可以通过配置限制 ctx 窗口大小,在配置 ~/.codex/config.toml里面修改:
model = "gpt-5.6-sol"
model_context_window = 1000000
model_auto_compact_token_limit = 900000
5. 简单任务交给便宜模型
不要让最贵的模型处理所有事情。可以把任务按“是否需要长链路推理”分层:
- 低难度任务:搜索文件、解释一段代码、生成提交信息、格式化、简单重命名,交给便宜模型,例如 DeepSeek V4.1 或是最近很火的 Jev,不仅快,还省 token;
- 中等任务:局部实现、补测试、修复明确的 bug,使用中档模型;
- 高难度任务:架构设计、跨模块重构、复杂调试、需要多次工具调用的任务,再使用 GPT 6。
6. Jev
我这里重点说一下最近很火的 Jev 这个模型,以及如何用它节省 token,有几个数据值得关注:
- 响应速度 70 到 500 毫秒,比主流前沿大模型的 3 到 329 秒快了一到两个数量级。
- 输入 Token 价格 0.042 美元/百万 Token(约 42 美元处理十亿 Token),输出 Token 免费。官方自称比同等智能水平的大模型快 20 到 200 倍,便宜 40 到 400 倍。
所以你以为 Jev 又是一个文本小模型? 其实不是,Jev 不能生成文本。它输出的是事先定义好结构的决策结果,每个回答都附带置信度分数。
我看社区里面有一些应用场景可以关注一下:
1、computer use 将Jev用作操作判断层,指导模型快速操作你的电脑 https://x.com/gregpr07/status/2100411066966749359
2、上下文压缩 由Jev判断上下文内容的重要信息,实现近乎即时的上下文压缩 https://x.com/tamarajtran/status/2100694549362553153
3、模型路由 根据任务复杂程度自动分配合适的模型来处理 https://x.com/mdlahfir/status/2100314182201802811
4、自动审核 比5.6 luna还要便宜且精准的自动审核模型,可能是Codex在安全审批方面最合适的工具 https://x.com/fazxes/status/2100300097695232164
使用的话要去官网 https://typesafe.ai 申请。不过我感觉这项技术 openai 或 anthropic 应该很快就会跟进,我已经看到很多社区里面的人在复刻了:https://github.com/TheoLeeCJ/openjev
7. 利用 ChatGPT的网页版
ChatGPT的网页版有一个超强的模型GPT-6 Pro, 它的额度是跟Codex分开的,并不消耗你的Codex额度。
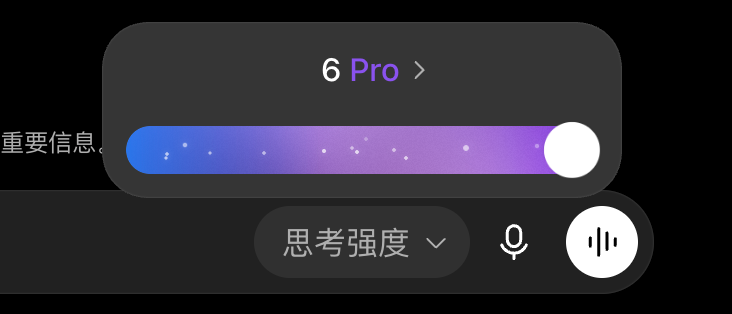
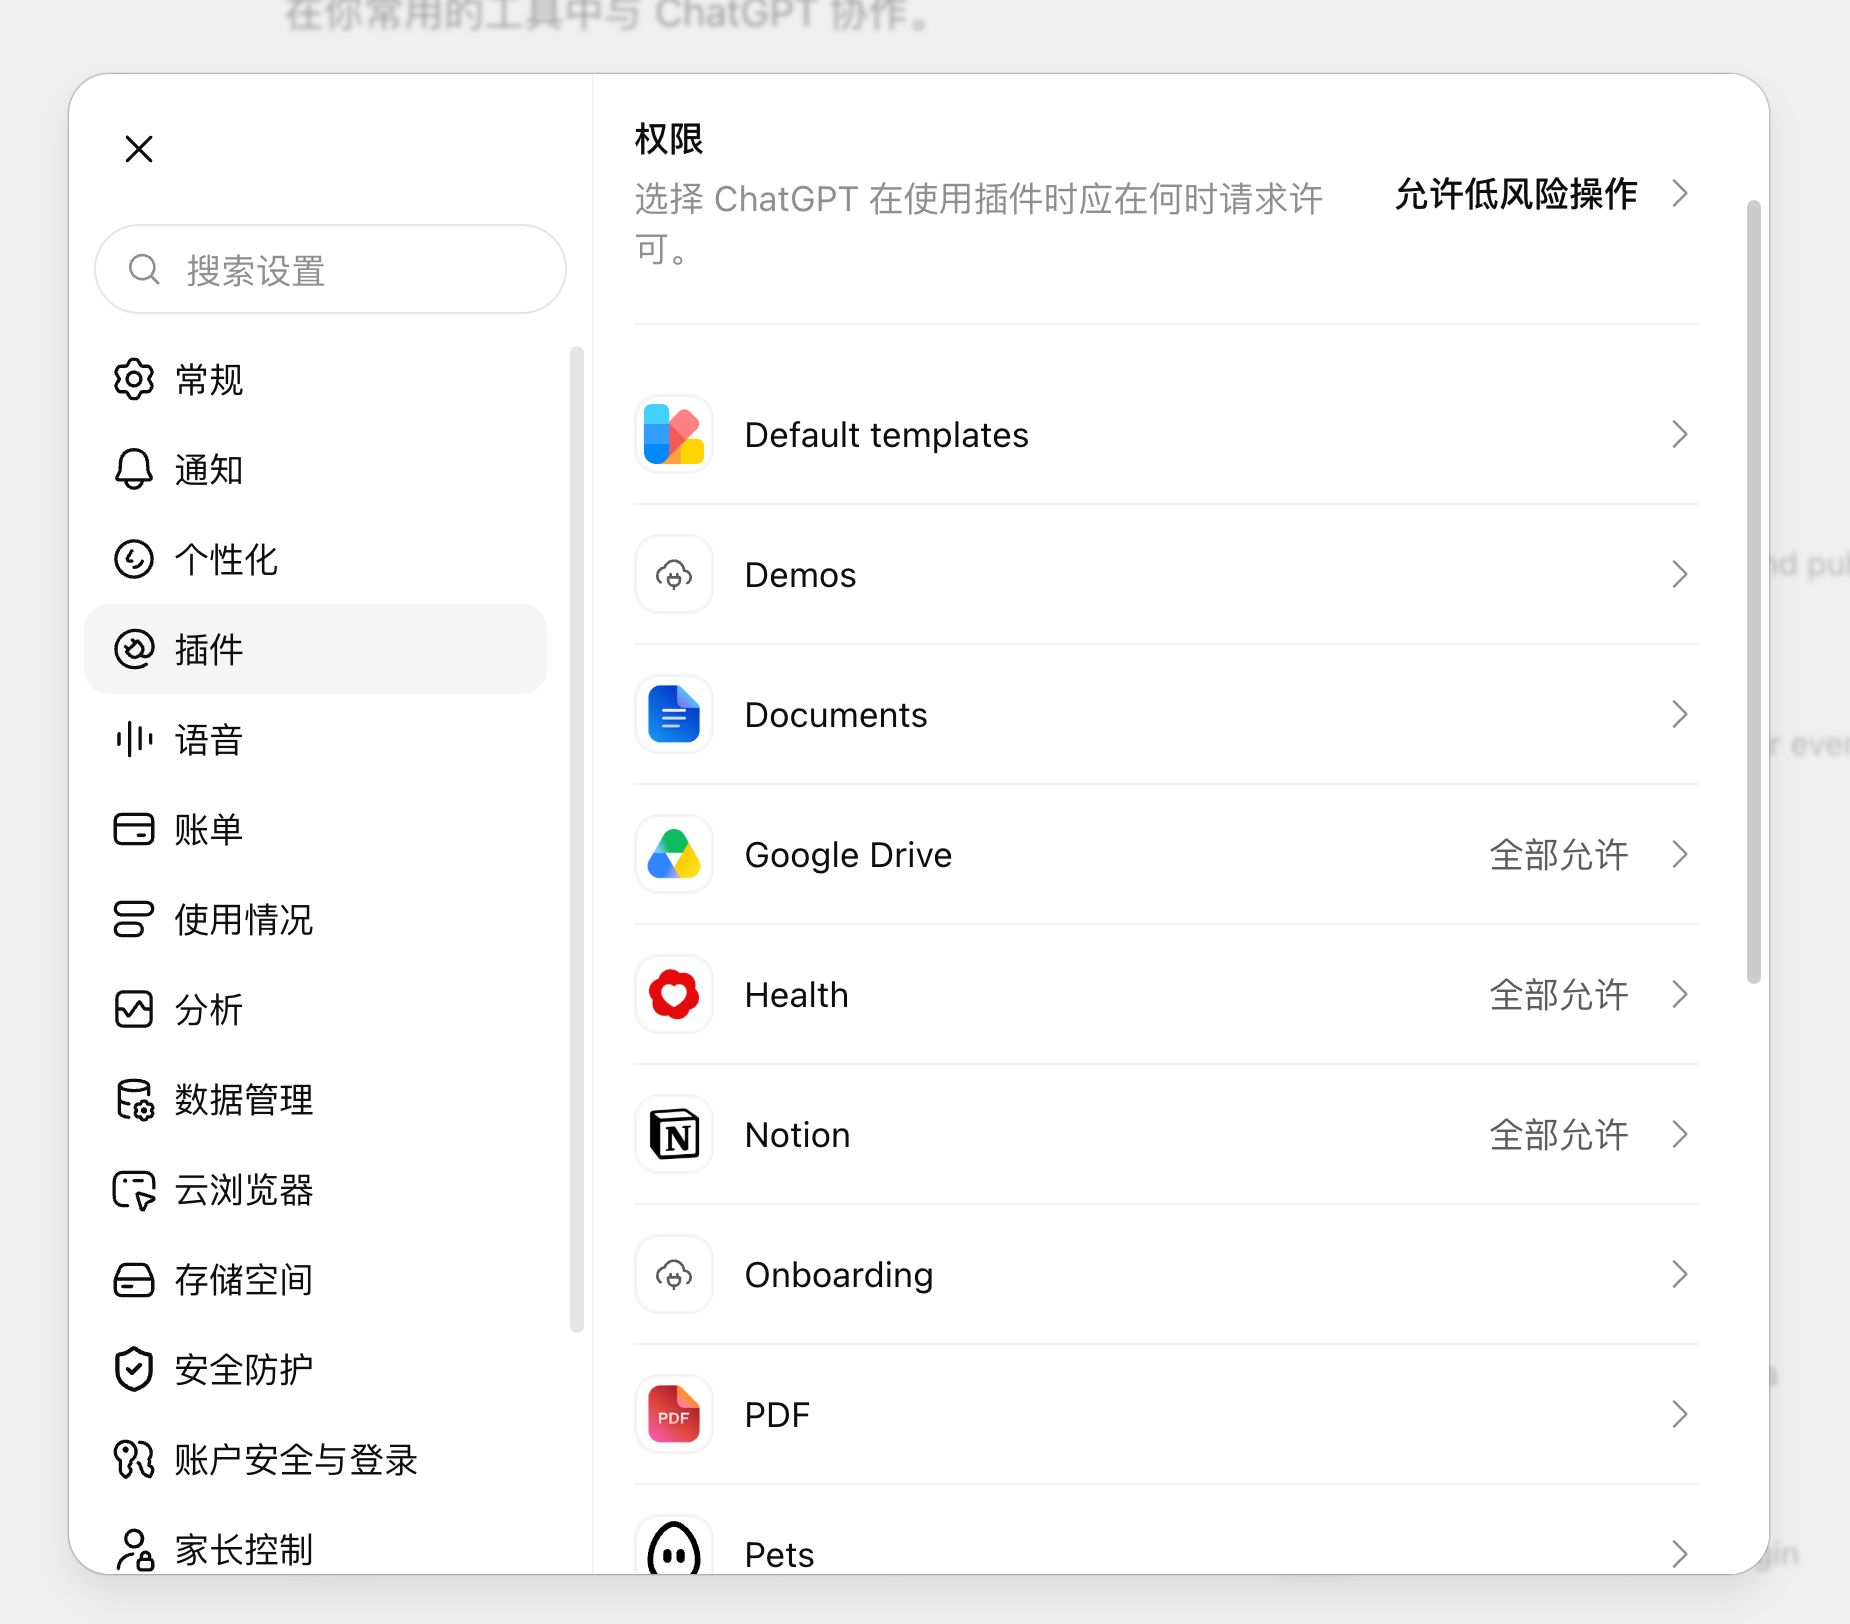
200刀的Pro会员,一周有200次的Pro对话额度。但是GPT Pro模型一直有一个问题,就是没有办法看到真实的业务数据和场景,所以可以让它通过插件的方式链接 Github,当然如果不用 Github 的可能就用不了了。
它也有很多插件,如果没有可以契合的话,可以自己写个 mcp 连接就行了:
Reference
https://x.com/pvncher/status/2095991462416490862?s=20